
随着改革开放的进一步深入,国人的物质生活和精神生活都有了长足的进步。不但有了五一和国庆长假,而且新兴的HTPC的门槛也是越来越低了。长假里出门旅游固然是一种不错的消遣方式,但出行难也是客观存在的问题,每年国庆家电卖场也都有大促销,今年国庆装台HTPC,看大片,度长假也是一种理想的选择。现在就为大家提供了一套不足万元的HTPC解决方案,我们一起来看看吧。
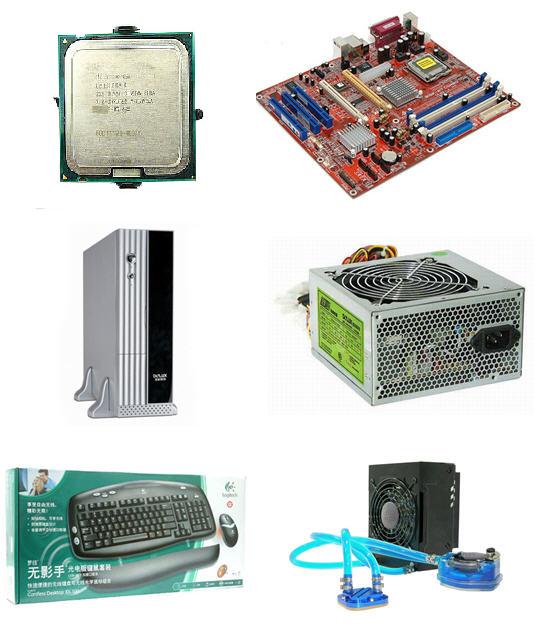
这套配置非常令人神往,可以说是内外兼修的标准HTPC配置。虽说双核是趋势,但是有HTPC显卡和双通道2G内存的帮忙,3.2G主频的赛扬D 352轻松完成对高清的支持应该是十拿九稳的。
报价仅为399的映泰915P-A7 Combo主板是市场上硕果仅存的915P主板,支持DDR/DDR2内存,支持双显卡模式,配置高、价格低,能够理想地控制成本。 酷冷海雕水冷方案的应用是为了降低噪音,提高整机稳定性,这个自然是不必多说。
罗技无影手是HTPC的标配,价格合理,性能表现稳定。多彩DLC-B166+DLP-410A是大主板、大电源、低噪音、高性能的结合体,多彩DLC-B166机箱外观相当漂亮,而DLP-410A的电源采用大风车设计,低转速、高转换率、高功率,足以拿下这套配置的需要。
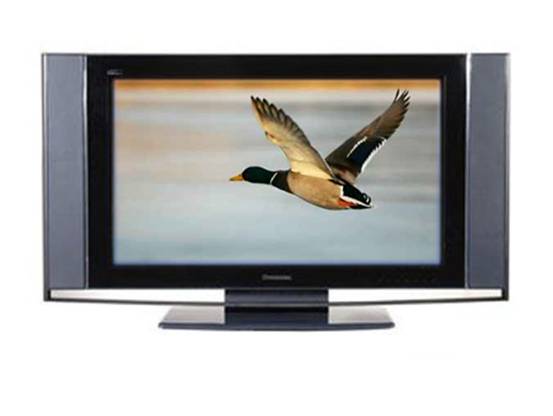
40英寸长虹大液晶电视6900元的报价给人不小的惊喜,轻松步入寻常百姓家。支持大尺寸需要大显存,支持NV TC技术的映泰V8402GL26显卡给您带来不小的惊喜。
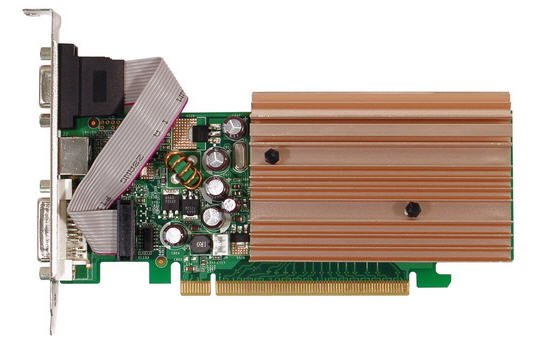
映泰V8402GL26显卡采用核心代号为G86-213,一样拥有16个流处理器,基本配备256M显存,支持64bit显存位宽。V8402GL26显卡还有一个更大的目标是使用G8X的解码方案,对H.264硬件解码和HDMI/HDCP的良好支持,使用刀版解决方案以节约机箱内部空间。
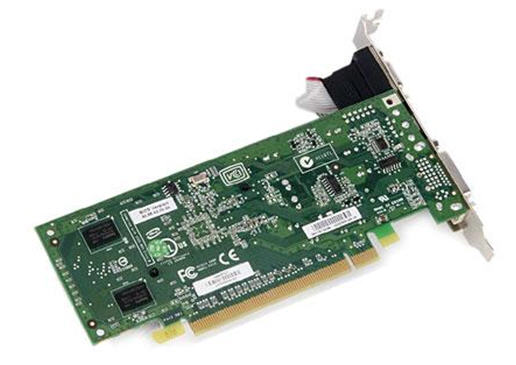
映泰V8402GL26显卡简约的PCB即使在后部看来依然如此,虽然走线清晰可的确能够节省不少元件。下面再来看看细节部分,除了PCB之外,与8500GT又有怎样的区别,从我们看到的仅有几个电容元件位置看,这的确是一款公版PCB,承载着总体不够10个电容,就完成了整个PCB的滤波过程,不过划一的元器件布局和整齐的贴片显示了映泰作为AIC工厂的生产实力。
我们已经很难在目前主流显卡上看到如此迷你的散热器了!8400GS在与8500GT之间,除了64Bit显存位宽制约之外,在频率设置上已经是完全相同,究竟这款如此迷你的散热器对8400GS有无帮助?那么,8400GS在其他设置方面,尤其是显存颗粒设置上又会怎样?接下来看看:相当有意思的是,映泰V8402GL26显卡配备了3.7ns颗粒显存,默认出厂频率设置在533MHz,发热量微乎其微。
接口方面采用了全整合设计,其实就目前LCD的普及速度来看,刀版设计的映泰V8402GL26显卡完全可以省略VGA接口的设计而在附件中加上转接口的设计,更节约成本。
Tubro Cache,NVIDIA的显存魔术
不要以为Tubro Cache是DIME技术(Direct Memory Execute,直接内存执行)的翻版,事实上NVIDIA的Tubro Cache技术相对于DIME有了质的飞跃。首先最大的不同就是整个Tubro Cache技术是构建在PCI Express连接上的。图形卡专用的PCI Express X16接口有有着双向8GB的带宽,同时串行的特性也让各种直接内存操作实现起来更为容易。当然,以往DIME无法实现的把帧缓存动态分配到系统内存上这个功能也被成功的实现。你或许会问,普通的PCI Express X16图形卡不也能调用系统内存进行渲染吗?是的他们的确能够调用系统内存存放纹理,但帧缓存就无能为力了。而他们对于纹理处理的实现方法,更多的是在本地显存中完成纹理处理之后copy到系统内存中暂时存放而已,根本无法直接对存放在系统内存中的纹理进行操作。
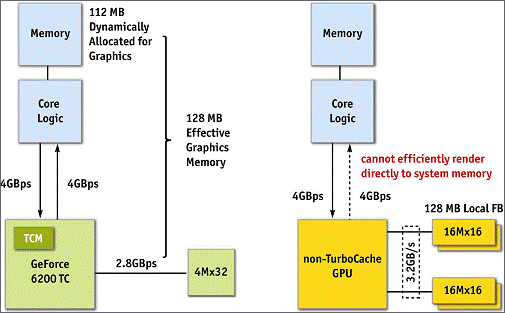
普通共享内存架构和TC技术对比
要实现高速的共享系统内存功能,就必须对现有的GPU架构进行一些改动使得整个共享内存架构变得更为高效。在NVIDIA的Tubro Cache中负责管理整个显存调用主角叫做MMU(内存管理单元)。这个单元能够自行协调各种帧缓存、纹理的存放位置。对于GPU来说,MMU接近于“透明”。GPU只管对MMU发出寻址指令即可,剩下的工作将会由MMU代为完成。
MMU的工作将会在3D流程进入象素流水线开始,NVIDIA的驱动和MMU将会确定把那些纹理放在系统内存,那些纹理放在本地显存。之后NV44便能对这些数据进行直接的渲染和各种操作。如果该对象在系统内存中则在完成渲染之后,还将会由MMU把最终结果从内存中取出,然后交给ROP进行最终的光栅化操作。完成这一切之后,MMC还将释放之前占用的系统内存空间,其他应用程序便能够接着使用这些空间。







